24:yolo-26的基本结构
YOLO26
原文: Ultralytics YOLO26: Unified Real-Time End-to-End Vision Models
代码: ultralytics/ultralytics
网络解决的核心问题
YOLO26 主要解决三个问题:依赖 NMS、DFL 检测头较重且回归范围受限、小目标可能没有正样本。
网络整体结构
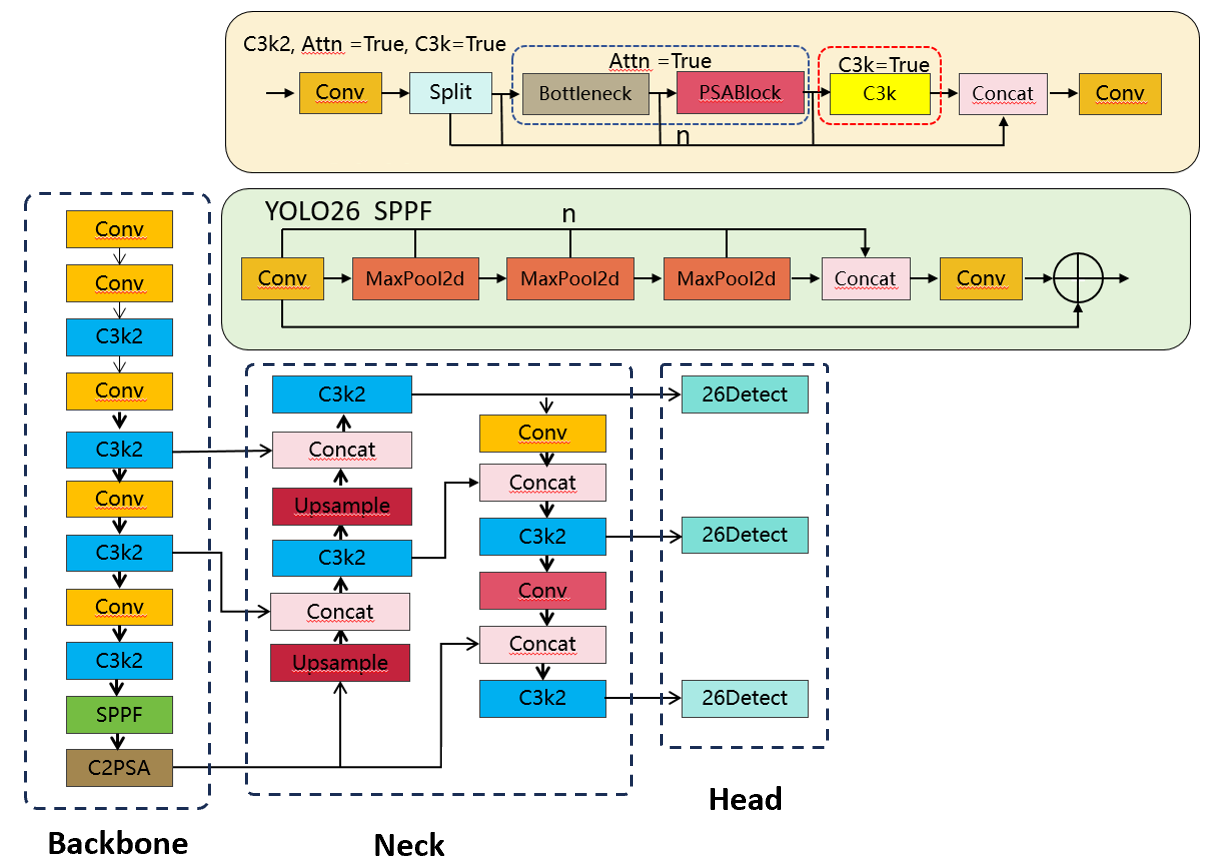
YOLO26 沿用 YOLO11 的基本框架,主要改进检测头、标签分配和训练方法,并对 Backbone/Neck 做轻量调整(如增加注意力机制)。
训练策略
1. 双检测头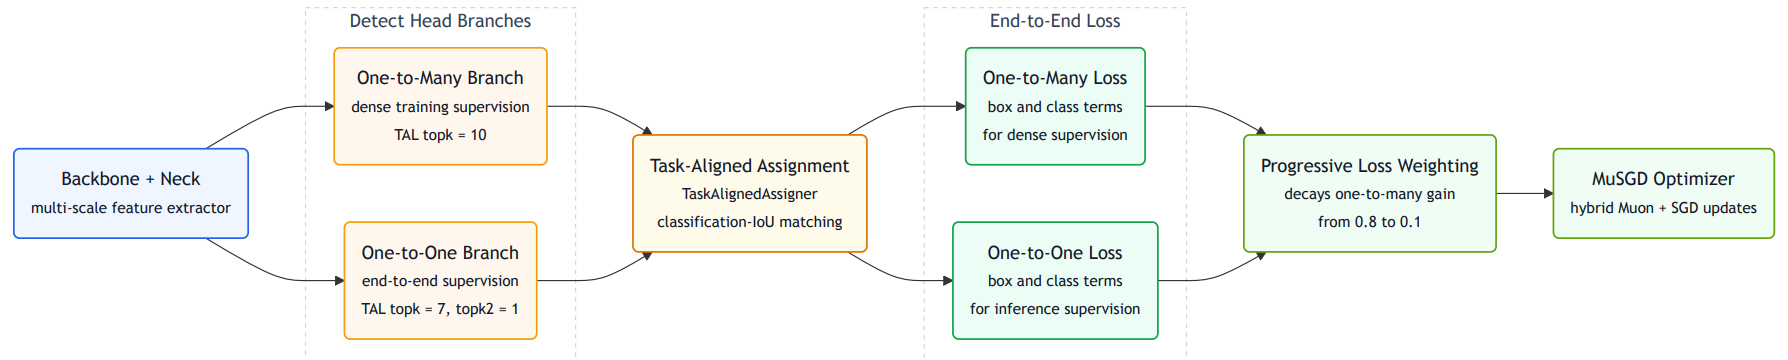
图 2:YOLO26 双检测头训练流程。
一对多头提供密集监督,一对一头负责无 NMS 推理。Progressive Loss 将训练重点逐渐转向一对一头。
2. 移除 DFL:YOLO26 以直接框回归和 L1 损失替代 DFL,减轻检测头并解除回归范围限制。
3. 小目标标签分配:STAL 在候选筛选时临时放大小框,使其获得正样本。
4. 其它改进:MuSGD 用于加快收敛等等。
YOLO26 训练流程
- Backbone + Neck:生成多尺度特征图和固定网格预测点。
- 两个检测头分支:每个网格点分别输出类别分数和预测框。
- Task-Aligned Assignment:根据当前预测和真实标注为两个分支选择正样本。一对多分支为每个目标选择多个点;一对一分支最终只保留一个点。
- 两类 Loss:分别使用各自选中的正样本计算分类损失和边界框损失。
- Progressive Loss Weighting:训练后期逐渐降低一对多损失的权重,更重视一对一分支。
- MuSGD Optimizer:根据总损失更新网络参数。
实验结果
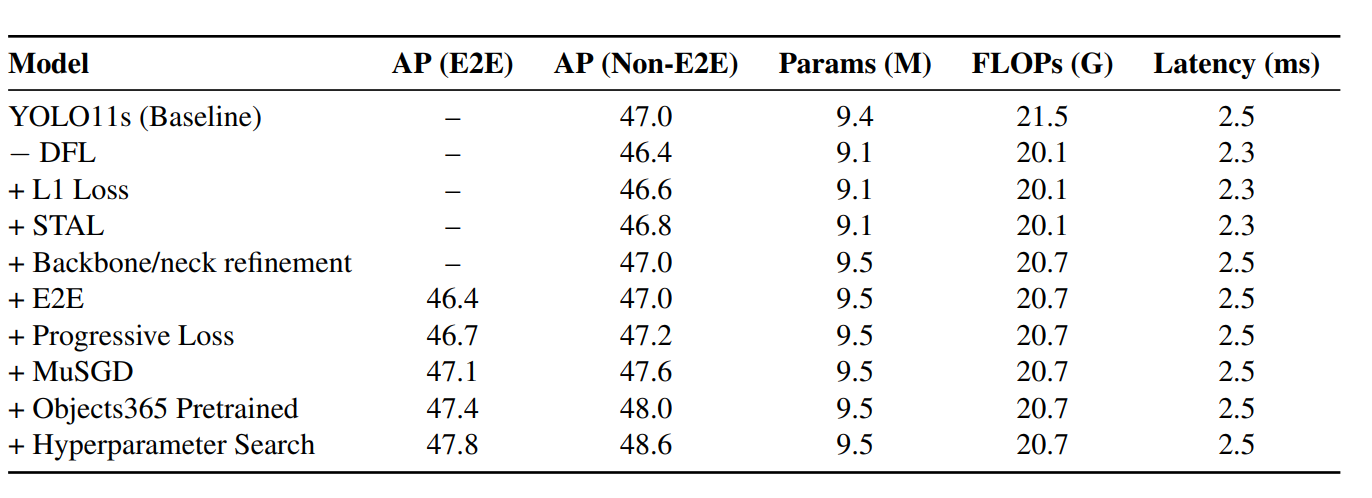
结果表明,移除 DFL 能降低模型复杂度和推理开销,但会暂时损失精度;L1、STAL 和 Backbone/Neck 改进可以弥补这部分损失。端到端训练、Progressive Loss、MuSGD、预训练和超参数搜索则进一步提升性能,说明 YOLO26 的效果来自多项结构与训练策略的协同改进。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 plusone's blog!
相关推荐
2026-09-17
29:后续:八月的小结,读《我的世界观》
读《爱因斯坦选集》之《我的世界观》 这一篇文章的最后有这样的一句话: 如果你看到了,也请你和我一起朗读。 我们所能拥有的最美好的体验是神秘体验,这种基本情感是真正的艺术和真正的科学的策源地。谁要是不了解它,谁要是不再有好奇心和惊异感,就无异于行尸走肉,他的眼睛是黯淡无光的。正是这种对神秘的体验——即使夹杂着恐惧——产生了宗教。我们认识到有某种无法参透的东西存在着,感受到最深奥的理性和最灿烂的美以最原始的形式直通我们心灵,这种认识和情感构成了真正的宗教性;在这个意义上,也仅仅是在这个意义上,我才是一个笃信宗教的人。我无法想象有一个神会对自己的造物加以赏罚,也无法想象他会有我们所体验的那样一种意志。我不能也不愿想象一个人可以超越肉体死亡而存在;让那些脆弱的灵魂,出于恐惧或者荒谬的唯我论,去拿这些思想当宝贝吧!我满足于生命永恒的奥秘,满足于知晓和窥探现有世界的神奇结构,我能以诚挚的努力去领悟显示与自然之中的那个理性的一部分,哪怕只是极小的一部分,我也就心满意足了。 朝闻道生下来,是困惑的,我们有着十万的为什么,天天在爸爸妈妈面前为什么为什么的叫唤。 为什么天要下雨 为什么天是蓝色的...
2026-05-24
16:记录一次院士讲座
今天有幸,能够聆听一场院士的分享 图灵测试与大语言模型——关于通用人工智能的几点思考 最近这半年,AI发展实际上太快了。人工智能,铺天盖地。很多过去认为必须人来做的事情,都在被AI代替。最近发生的战争,人工智能已经完全改变了战争的形态。 源起,1956年的达特茅斯会议。 香农,信息论 造了一个这样的词汇artificial intelligence 图灵: 计算机科学之父,人工智能之父 数学家,逻辑学家 论可计算数及其判定问题上的应用,1936 计算机器与智能,1950年,computing machinery and intelligence 图灵测试:机器能思考吗? 人工智能(AI),不如机器智能(MI)更加恰当。 他一生中发表的文章不超过十篇 通用图灵机,1936离散有限状态机,到目前为止,这是对计算机最通俗直观的模型 computing machinery and intelligence1950年,图灵问题的提出,机器能思考吗“机器”:数字计算机,通用图灵机,离散有限状态机“思考”是一个无法准确定义的模糊概念,因而讨论能否并没有意义 模仿游戏根据C,A男生,B是...

2026-04-21
E1.2 C语言程序设计
把今天认真折叠好,明天自然会有展开的光 常量常量是程序中最基本的元素,有字符常量,整数常量,浮点数常量和枚举常量。字符常量要用单引号括起来,例如上面的'}',单引号只能括一个字符而不能像双引号那样括一串字符。在格式化字符串中%号(Percent Sign)后面加上字母c、d、f分别表示字符型、整型和浮点型的转换说明(Conversion Specification). 1、总结前面介绍的转义序列的规律,想想在printf的格式化字符串中怎么表示一个%字符?写个小程序试验一下。 其它的他多数符号,都是用反斜杠\进行转义,但是对于%而言,是用其本身进行转义,即为%% 123456#include <stdio.h>int main(){int score = 100;printf("小明的准确率是:%d%%\n",score);return 0;} 变量变量(Variable)是编程语言最重要的概念之一,变量是计算机存储器中的一块命名的空间,可以在里面存储一个值(Value),存储的值是可以随时变的,比如这次存...
2026-02-28
1:bilibili下载器
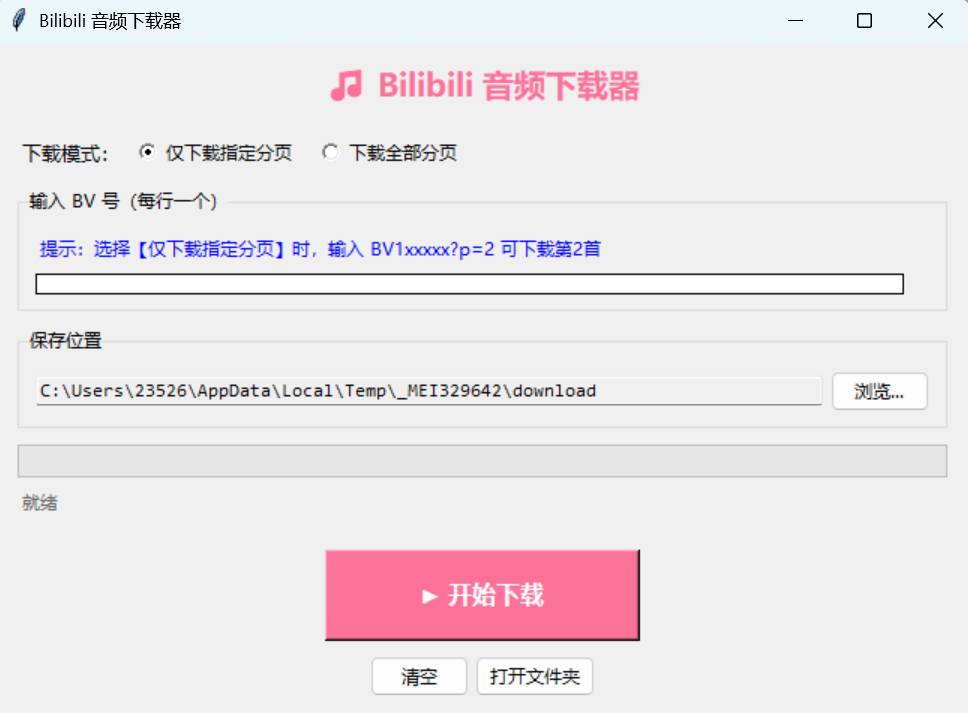
最近喜欢听钢琴曲,但很多曲子在音乐上都没有,而且很多音乐的曲子在音乐平台上都是没有的,又或者有些是UP主的天赋,很想下下来,放在耳机里循环欣赏,于是有了这个想法 参考 pangguy/bilibiliAudioDownloader-1: 输入视频BV号列表,批量下载B站视频中的音频到本地。 https://github.com/Henryhaohao/Bilibili_video_download https://github.com/SocialSisterYi/bilibili-API-collect 改进原有的代码在2021年最后一次进行更新,我们在现在进行复现,并且随着哔哩哔哩的反爬技术进一步的更新,我们需要进行一些改进,最后在原有的代码基础上,我们将其封装成为exe文件,供没有python环境的音乐爱好者们可以一起欣赏 主要功能输入视频BV号,下载B站视频中的音频到本地。 使用方法在哔站上复制BV号,然后按需要点击下载即可 获取https://github.com/lijiayi-plus/bilibili-audio-downloader-v2
2026-05-05
8:caformer的复现
概述我们进入OSformer的复现,论文名称为Cross-domain-aware deep unfolding transformer for hyperspectral image super-resolution,提供的源代码https://github.com/Caoxuheng/HIFtool,这是一个高光谱融合方向的一个项目融合包,里面提供了多种方法,大致分为三类:model-based,supervised,unsupervised.我们的OSformer就是基于监督学习的一个方法 数据集在文件夹multispectual image dataset中,我们可以看到一共有如下的五个文件夹,分别是 CAVE chikusei Pavia QB xiongan我们按照文件夹里面的md文件进行下载 bug调试20260225经过了一个春节小长假,调试的进度需要重新找回来。由于我们的笔记本的32G的内存不足以加载需要60G内存的程序,而在Linux中出现killed报错,我们在autodl中新建了一个实例,用以解决问题。autodl的一大好处是,其中的内存有120G,远...
2026-04-23
4:读后感——何为好的论文
读后感尼古拉斯-卡里尼,和他的网站:如何赢得最佳论文奖 (或者,关于如何进行重要研究的个人观点) 仅仅做一个记录,来自一个科研的小白。 想出最值得写论文的点子要有好的品味,去挑选一个问题 The single most important skill to develop for high-impact research is good taste in what problems are worth solving. If you have good taste, and you keep writing papers, eventually you’ll write one with exceptionally high impact. But if you have bad taste, you could write a hundred papers and never do anything of consequence. 也许我们可以发一百篇论文,但如果我们的文字不具有品味,不是在一开始就在做一件正确的事,那么也许,我们终其一生,never do anything ...