26:挑战杯初赛资料&思路
挑战杯初赛打榜还不错,全国第七,现把一些小的思路给同步一下
对于一个目标检测的算法,以及一个刷分且有答辩的竞赛。我们的思路实际上非常简单,一方面去各种堆叠各种创新,达到每个类别的sota,另一方面是要有理有据的创新,有着比较强的理论性,从而能在最终的答辩中比较出彩。
(18 封私信 / 80 条消息) DOTAv2遥感图像旋转目标检测竞赛经验分享(Swin Transformer + Anchor free/based方案) - 知乎这一篇知乎,大佬很好地阐述了我们该如何打遥感类目标识别的竞赛,如何用细节去加点。
一、竞赛规则
1.1评价指标
赛方要求的评价指标是,召回率(recall,后续用R值表示)以及虚警率,1-虚警率即为准确率(precision,后续用P值表示)。
在一般的比赛中,评估用指标主要是mAP,用来衡量一个模型的整体的能力,而P值和R值,则是在IOU(计算重合程度)和conf(置信度)两个超参确定的情况下,计算出来的结果。一般而言,IOU的要求是0.5,conf可以自己调节。但是为了我们在训练阶段可以看出每个网络的强弱,我们用IOU=0.5和conf=0.3的结果进行评估与对比
其次,赛方要求对于单幅 10,000×10,000 像素图像推理时间≤20 秒。这是一个实时性要求比较高的指标。大幅图片涉及到切片进行处理的难点。总体而言,需要一个轻量,快速的算法。
**但是,只有上述的,PR值和时间三个指标还远远不够“。
我们的题目讲述了我们要解决的几个核心问题(读题):
- 小目标
- 小样本,类别不均衡
- 多尺度目标分布
所以我们还需要一些对应的指标或者数据:
- 小目标类别,即FSC,相比于baseline我们的model有多大的提升,最终达到了多少。
- 小样本类别,比如说HM和LQS,FSC,这三项的指标,最后达到了多少。
- 不同类的检测能力:也即对于飞机类,船类,fsc类我们都有很好的mAP
1.2数据研究
对于数据集需要了解透彻,一个是可以知道我们的网络该如何去设计,另一个可以从对应的数据集去找sota模型。
1.2.1数量占比和分布情况
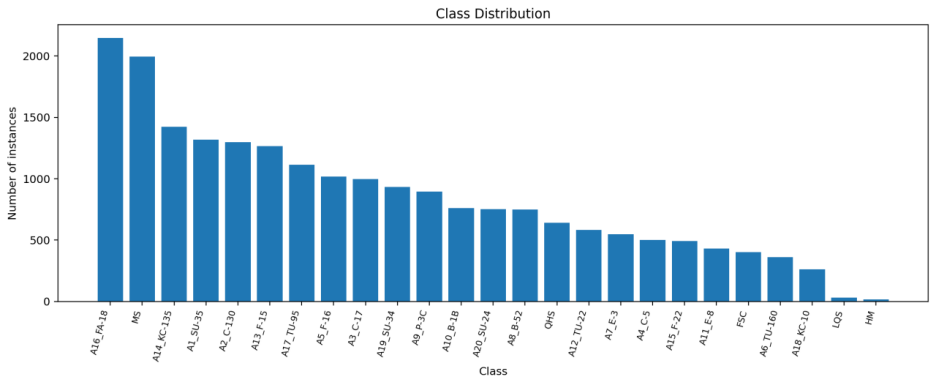
类别总体失衡不严重,不会出现头部主导的情况。但是存在小样本情况,尤其是HM和LQS两样。
但是数据的分类比有着不平衡,飞机类总体的训练数量较多,FSC单列一类,也有一定的数量。船类整体较少且相应的训练语料有所缺失。同时我们也看到,飞机的内部也存在着数据集的数量的不同,船的内部语料的极差非常明显。
所以,对于“船类”而言,内部的类别差距是非常大的,调节loss或者数据增广都是可用的加点的方法。但是因为民船很多导致负梯度确实很大,也可以考虑去单点检测器。所以,船的内部的数据是极不均衡的,网络的训练会被头部类别主导,这是后续的一个问题。
1.2.2尺寸信息
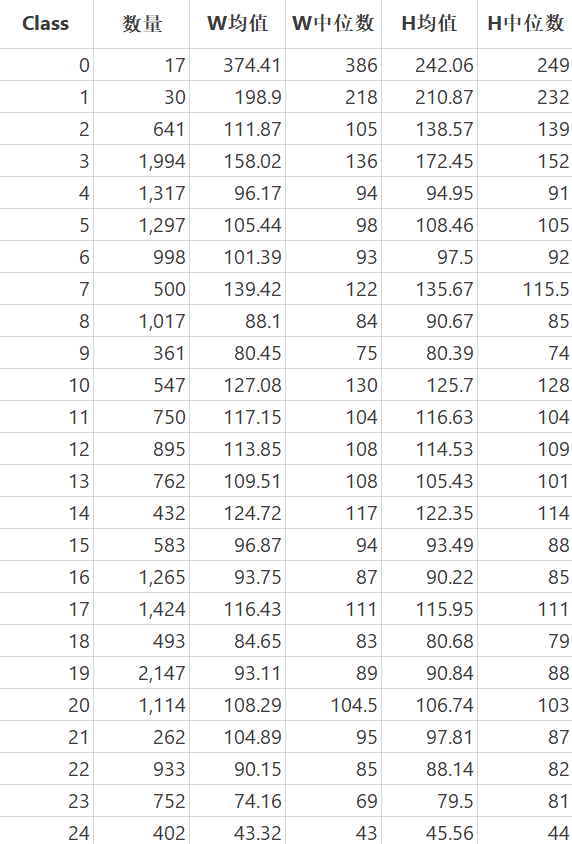
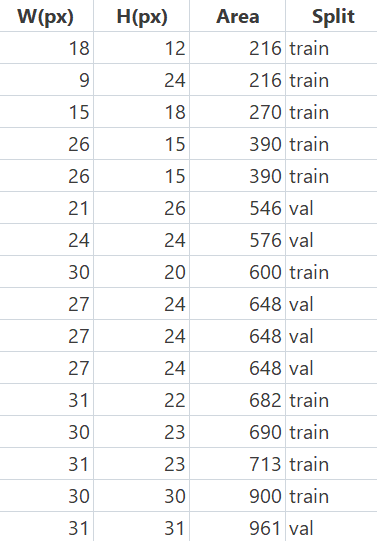
如上图的W和H,展现图像的整体的像素信息,一般而言,32乘32以下我们叫做小目标,可见真正意义上的小目标实际是比较有限的,也只有FSC可以算作是小目标,我们以32乘32,统计了真正的小目标数量,一共19个小目标如下所示。
同时,根据我们现有的结果,P3-P5或者P3-P6的backbone,能够很好的提取目标,完成相关的任务,P3能够非常好完成飞机的尺寸(大几十个像素甚至上百个像素)的检测。而对于船类,经常是大几百的像素,这里体现的是尺度的差异。
而对于FSC,需要使用到P2进行检测,才能获取信息与分辨。
1.3.3特殊标注
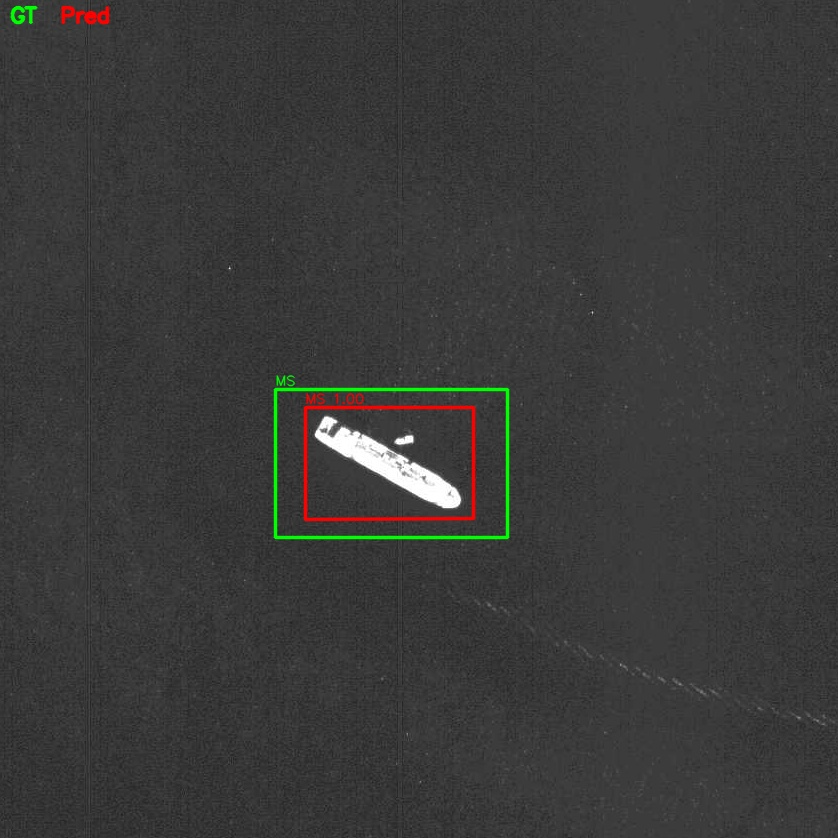
赛方的数据集有一些不是很行。可以推断的是,赛方的数据集来自于几个部分。比如mar20这样的。但是有一些可以推断是赛方手动标注的,效果不是很行,框松松垮垮,其它目前还没有发现。
1.3.4长宽比
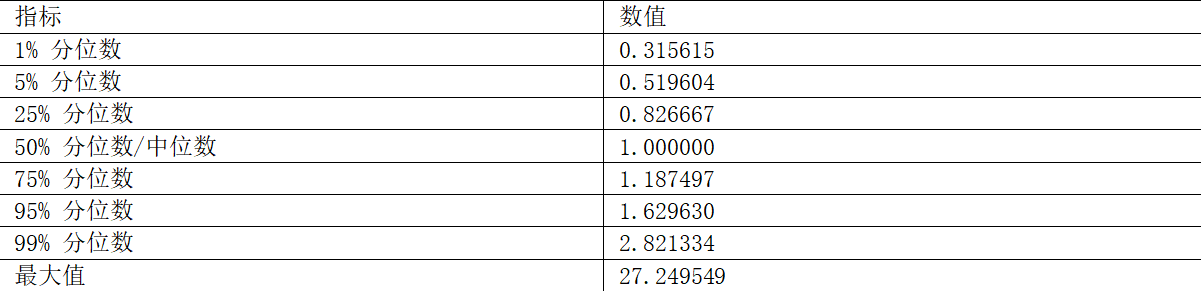
1:3左右的长宽比,就比较合适。可以在yolo生成框的部分予以体现。
后续可以看看情况,因为飞机类是不用考虑到长宽比的,非常的均衡。但是船就需要考虑长宽比。
二、baseline选择
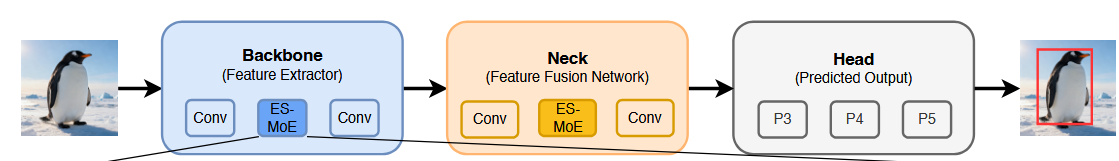
每一个检测的网络,大体上都可以分为上图的几个部分,从左到右是:input->backbone->neck->head->output。很多时候,我们可以在这里面进行排列组合
- input:数据预处理和输入数据,这里无论是在训练还是检测,都有文章可以做
- backbone:特征提取网络,我们目前试过的有:yolo26l的backbone,yolo11的backbone,lsknet,swin transformer。主要是卷积类和resnet类,需要了解提取的不同的层次,即P层次,下面会讲
- neck:特征金字塔结构,承接backbone提取的不同层次的信息
- head:分类头,我们目前有的是yolo范式,rcnn二阶段范式,还有rtmdet的范式。
2.1 backbone部分
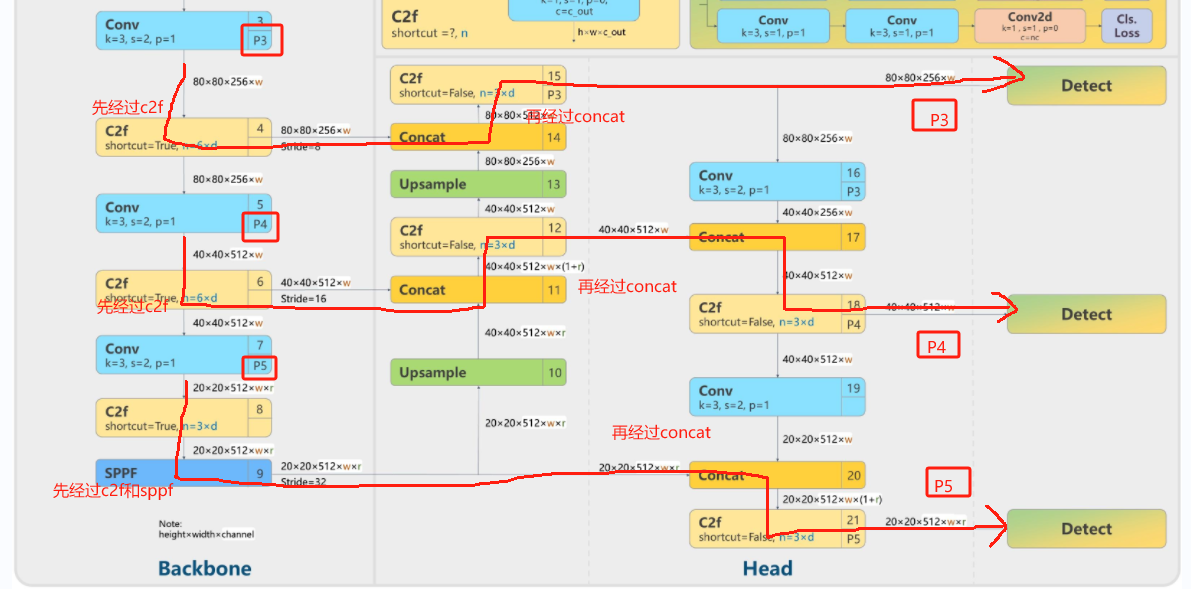
以上图是一个yolo8的结构图,可以很好的解释啥是backbone提取的不同层。
backbone:假设输入为640乘640,每次卷积称为一次P(共5次,P1、P2、P3、P4、P5);每次卷积操作后输出特征图大小为输入特征图大小的1/2(320乘320)1/4(160乘160)1/8(80乘80)1/16(40乘40)1/32(20乘20)
如果是一个小于32的目标,可能P3就不能很分辨清楚了。如果目标很小的话,P3这样的网络已经看不到目标了。
我们的backbone使用的层级:
- yolo26:p3-p5
- lsknet:p3-p6
- rtmdet:p3-p5,swin transformer改版以后是p3-p6。
- 或者试试很多的resnet
这方面就是搭积木,当然需要一个合适的预训练权重。
模型结构认识的方面,一定要知道两个概念,Resnet和CNN,以及很多结构,大部分是其中的组合。或者上面的多种backbone进行融合提出自己的。
2.2 neck和head
调研不是很多,但是这方面的网络是很多的,需要不少的消融实验。
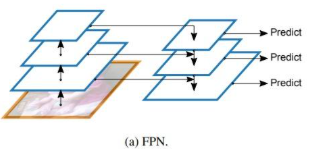
这展示的就是一个neck的结构,上图右边的部分,又叫做特征金字塔。左边的是检测网络的backbone和各个卷积层后输出的数据。
neck有很多,可以换:
PANet,ASFF,NAS-FPN,BiFPN,Recursive-FPN。了解不是很多。
检测主要分三类
- YOLO类,一阶段检测
- rcnn类,两个阶段检测
- rtmdet,比较特别的检测
2.3 船backbone
考虑到船和飞机在尺度上的差别的确非常大,还要去找合适的backbone
三、数据的工作
赛方的数据很一坨,目前统计下来有几个特征:
1.三个数据集拼凑,像素大小差距大
2.船的内部数据极差不小
3.FSC小目标,真的很难缠啊
4.飞机内部也有数据多少的分别,但不是主要的
接下来是我们要完成的工作:
3.1 框校准
这里面需要用嘉成的rtmdet的p6 swin transformer的加强版的结果,作为一个初版,我们要人工去搞赛方数据集里面船舶的图,手标微调进行修正。mar20和另一个我感觉还是很紧密的。
既然明确了是加分项,那么我们就一定得完成这个任务。
3.2 船数据增强
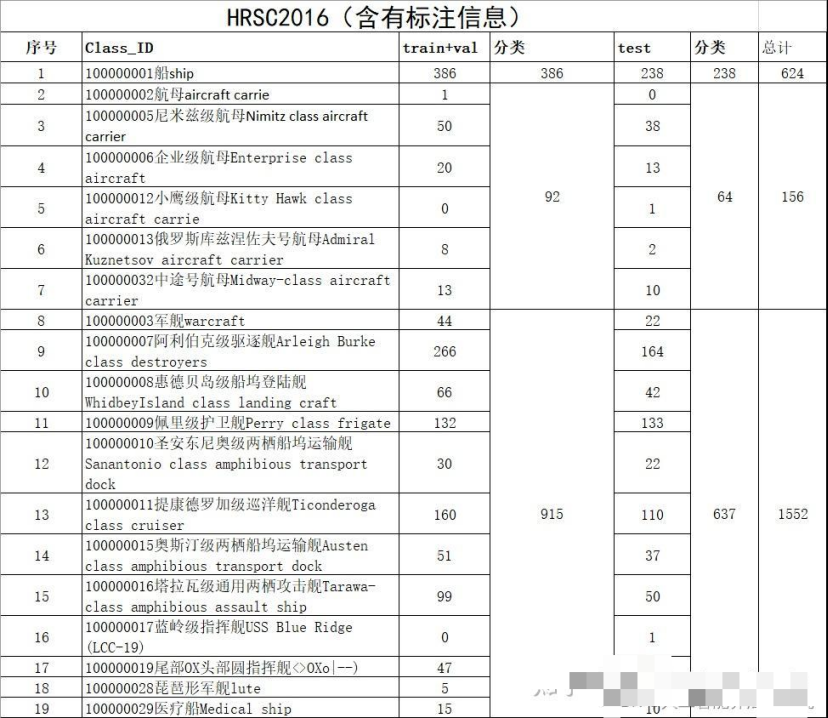
HRSC数据集是一个不错的我们可以用的模板,我们把里面的数据集按照航母,护卫和驱逐舰,两栖舰进行分类,作为我们的训练集。
- train,val,test合成在一起
- 重新改标签划分成为三类
- 有针对性的增加航母,两栖舰的数据集
这里面民船特别多,远超现有的数据集,可以考虑“单独来一个检测器”。
3.3大图的构建
没有大图,我们的模型的速度无从计算,所以需要大图。
- 看看有没有其它的大幅面的数据集
- 或者找几个dotav2的大图。有机场,船就OK,只看推理速度
- 实在不行,拿一堆评估集直接合成,有现有的成熟的方法,可以试试,但是有点难啊
3.4 预训练数据集的构建
事实证明,预训练对于最终结果是非常重要的。
我们的权重最后只给backbone和neck,最后的头因为类别不同一般是重新进行训练的。视觉很多是用imagenet进行训练,但是我们是遥感的数据集。
修改fair1m数据集,只找对我们有用的标签,然后去训预训练权重,是一个不错的思路。
四、模型构建
4.1 分类思路
可以有一个预设的前提,就是:
1 |
|
所以可以前置一个二分类,作为场景的判断,海和飞机分别运行各自的检测算法,不并行。
属于一个MOE的思路,考虑到数据集的特性,是一个刷点的选择
4.2 删patch思路
不是所有的patch都要进入backbone,可以前置不用网络的判断,比如说首先卷积一次提取边缘,然后用FFT滤波或者直接叠加一个门控或者是设置一个阈值,让部分的patch不用进入后面的部分。
比如说海洋的场景,大把大把的patch是用不到的,我们直接不检测那一些patch。但是需要考虑到船的大小的因素在,设计切分patch的逻辑。
4.3 图像金字塔思路
考虑到最后的测试集不善良,同时也为了提升我们模型的鲁棒性。
图像金字塔就是指对于一个图像,比如一个证件照,生成1寸,2寸,4寸的信息,通过上采样或下采样。这样虽然是同样的一个目标,有的像素很小,而有的像素很大。
在训练的过程中,同样的一个目标处于两个不同的尺度,可以增加模型的识别能力。
在检测的过程中,图像金字塔,比如小目标放大一个就不是小目标了,可以显著的增加点数。
有高斯金字塔和拉普拉斯金字塔
4.4 早退机制
哪怕经过了backbone,由于GPU的并行加速,时间耗费不多,主要在生成框和NMS的地方非常耗费速度,因为CPU是并行的计算。
所以可以考虑patch在经过backbone后面,设计一个二分类的网络,自己生成标签。这样确定没有目标的就可以直接执行早退机制了。
但是这个的有关研究,在20年前比较热门,如今冷门。
五、trick
5.1 长宽比
通过先验的图片长宽比,微调anchor free架构的代表两边之比比值的超参。可以减少生成框的数量,减少NMS运算量。
长宽尺寸对于anchor free的影响,anchor free的架构需要根据长宽比加上超参,目前看99%以上的数据的框都是1:3-3:1之间的,而且需要限制这个的主要是船类,不是飞机和车。只用在船类的目标
5.2 FSC类目标
看看呗,最后FSC肯定要在P2的尺度解决问题,是backbone的部分就有P2,还是neck的部分P3上采样得到P2,都是可以试试的。反正要把FSC的指标给刷满。
5.3 调整损失函数
这个是比较重要的
- 可以通过focal loss这样的,抑制数据不均衡,但是数据差异最好不能大于15:1,可以减少小样本的影响
- 现在的框不精确,所以DFL这样的框的拟合就没有什么效果,还是很可惜的
六 总结
目前主要的思路是,通过MOE,分成船舶、飞机、FSC三个网络或者是船和(FSC+飞机)两个网络进行完成。可以是前置背景识别激活上述的分支,也可以是同时进行在后端进行融合。
在每一个小的专家上面指标达到sota,三个部分每一个单独拉开来都要是sota的级别。
速度方面,轻量级网络加多patch的图片同时输入争取吃满显存,拉满GPU实现大的性能。或者是分支选择激活,或者是并行,达到MOE的速度最大化。
后面为了速度而精修。